
etcd — сердце кластера
Всё состояние Kubernetes — каждый под, секрет, конфигмап и узел — живёт в одном месте: распределённом хранилище etcd. Пока etcd здоров, кластер можно пережить любые сбои. Потеряли etcd без бэкапа — потеряли кластер. Разберём, как устроено это хранилище, что такое кворум, как делать снапшоты и восстанавливаться.
Что такое etcd
etcd — распределённое консистентное хранилище «ключ-значение», разработанное в CoreOS и переданное фонду CNCF. Название расшифровывается как «/etc distributed»: как файл /etc хранит конфигурацию одной Linux-системы, так etcd хранит конфигурацию всего распределённого кластера.
В контексте Kubernetes etcd выполняет роль единственного источника истины:
- все объекты API (поды, деплойменты, сервисы, секреты...) сериализуются и записываются в etcd;
kube-apiserver— единственный компонент, который общается с etcd напрямую; остальные ходят через него;- механизм watch позволяет apiserver и контроллерам подписываться на изменения ключей в реальном времени — на этом построена вся реактивность Kubernetes;
- механизм lease (аренды ключей с TTL) лежит в основе выборов лидеров контроллеров и проверки живости узлов.
Ключевые характеристики
| Свойство | Значение |
|---|---|
| Модель данных | Плоское пространство ключей с версионированием: /registry/pods/default/web-abc |
| Консистентность | Строгая (linearizable) для чтения и записи — за счёт алгоритма Raft |
| Протокол | gRPC поверх HTTP/2, весь трафик защищается mTLS |
| Ревизии | Каждое изменение увеличивает глобальную ревизию; старые значения доступны до компакции |
| Хранение | B+ дерево (boltdb/bbolt) на диске + журнал WAL (write-ahead log) |
| Лимит размера | По умолчанию 2 ГБ (настраивается до 8 ГБ) — etcd не рассчитан на гигантские объёмы |
Как устроена запись в etcd
Каждое изменение проходит три стадии — понимание этого конвейера объясняет и требования к дискам, и процедуры восстановления:
- WAL (write-ahead log). Запись сначала попадает в журнал опережающей записи и фиксируется на диске через fsync. Даже при внезапном отказе питания журнал позволяет восстановить состояние. Именно задержка fsync — критичнейшая метрика etcd.
- Применение к backend. Подтверждённая кворумом запись применяется к встроенной базе bbolt (B+ дерево), где формируется новая ревизия ключа.
- Периодические снапшоты backend. Когда журнал вырастает, etcd сбрасывает точку восстановления и обрезает старый WAL — поэтому на диске всегда есть и журнал, и файл базы.
Из этого следует практический вывод: etcd чувствителен не к объёму диска, а к его задержкам. Быстрый NVMe с стабильным fsync важнее терабайтов.
Версии ключей и ревизии
etcd хранит историю изменений: глобальный счётчик ревизий увеличивается на каждую операцию записи. Благодаря этому работают:
- watch с произвольной ревизии — контроллер может дочитать пропущенные события после кратковременного разрыва;
- оптимистичные блокировки — обновление «только если ревизия не изменилась» лежит в основе безопасного конкурентного доступа к объектам Kubernetes;
- компакция — история старше заданной ревизии периодически удаляется, чтобы база не росла бесконечно.
Алгоритм Raft и кворум
Чтобы переживать отказ отдельных серверов, etcd-узлы объединяются в кластер и синхронизируют данные по алгоритму консенсуса Raft. Упрощённо:
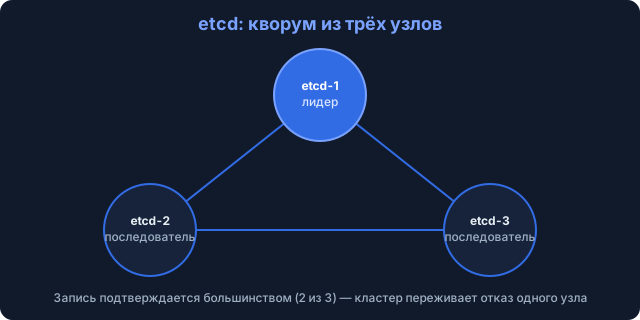
- Узлы выбирают лидера — все записи проходят через него.
- Лидер рассылает каждую запись остальным (followers); запись считается зафиксированной, когда её подтвердило большинство — кворум.
- Если лидер пропадает, оставшиеся узлы устраивают новые выборы за доли секунды.
Сколько узлов держать
| Размер кластера etcd | Кворум | Допустимый отказ | Оценка |
|---|---|---|---|
| 1 узел | 1 | 0 | Только для разработки: нет отказоустойчивости вовсе |
| 2 узла | 2 | 0 | Худший вариант: отказ любого узла убивает кворум, а сложность выросла |
| 3 узла | 2 | 1 | Стандарт для большинства кластеров: баланс надёжности и накладных расходов |
| 4 узла | 3 | 1 | Бессмысленно: переживает тот же один отказ, но кворум больше и записи медленнее |
| 5 узлов | 3 | 2 | Для крупных и критичных установок |
| 7 узлов | 4 | 3 | Практический максимум; дальше растут только задержки записи |
Топологии развёртывания
Есть два классических способа разместить etcd для Kubernetes:
| Топология | Описание | Плюсы и минусы |
|---|---|---|
| Stacked (совмещённая) | etcd запущен как статические поды на тех же трёх узлах, что и остальной control plane | Проще: меньше серверов, kubeadm делает это по умолчанию. Минус: отказ узла бьёт сразу по двум ролям |
| External (выделенная) | etcd живёт на трёх отдельных машинах, apiserver подключается к ним по сети | Изоляция и независимое масштабирование/обслуживание. Минус: больше инфраструктуры и настройки |
Для большинства кластеров достаточно stacked-топологии на трёх узлах. Выделенный etcd оправдан в очень крупных или особо критичных установках, а также когда узлы control plane часто пересоздаются.
Снапшоты: резервное копирование etcd
Регулярные снапшоты — главная страховка кластера. Работа выполняется утилитой etcdctl на любом узле etcd. Все команды требуют TLS-аутентификации: указываем CA, сертификат и ключ (в стандартной установке kubeadm они лежат в /etc/kubernetes/pki/etcd/).
Шаг 1. Проверить состояние кластера etcd
# список членов кластера etcd
etcdctl member list \
  --endpoints=127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key

# здоровье каждого endpoint
etcdctl endpoint health --cluster -w table \
  --endpoints=127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key

# статус: размер БД, ревизия, лидер
etcdctl endpoint status --cluster -w table \
  --endpoints=127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key
Шаг 2. Снять снапшот
etcdctl snapshot save /backup/etcd-snapshot-$(date +%Y%m%d-%H%M).db \
  --endpoints=127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key

# проверить целостность снапшота
etcdctl snapshot status /backup/etcd-snapshot-20261010-0300.db -w table
Снапшот снимается «на лету», без остановки etcd, и содержит полное консистентное состояние на момент начала чтения.
Шаг 3. Автоматизировать
Оберните команду в скрипт, запускайте по cron на узле control plane (или через CronJob с доступом к сертификатам) и складывайте файлы во внешнее хранилище. Храните несколько поколений: как минимум суточные за неделю и недельные за месяц.
Восстановление из снапшота
Сценарий: etcd потерян или повреждён безнадёжно. Идея восстановления — развернуть новый etcd-кластер из файла снапшота. Порядок для stacked-топологии kubeadm:
1. Остановить control plane
На всех узлах control plane остановите статические поды: переместите манифесты из /etc/kubernetes/manifests/ во временный каталог (kubelet сам погасит поды).
2. Восстановить данные на каждом узле
# на каждом из трёх узлов, со своим именем и адресом:
etcdctl snapshot restore /backup/etcd-snapshot-20261010-0300.db \
  --name=etcd-node-1 \
  --data-dir=/var/lib/etcd-restore \
  --initial-cluster=etcd-node-1=<peer-url-1>,etcd-node-2=<peer-url-2>,etcd-node-3=<peer-url-3> \
  --initial-cluster-token=etcd-restore-token \
  --initial-advertise-peer-urls=<peer-url-этого-узла>
Peer-url каждого узла — это адрес его peer-интерфейса: схема https, IP или имя узла, порт 2380 (например, <схема>://10.0.0.11:2380). Параметры --name и --initial-advertise-peer-urls на каждом узле свои, --initial-cluster и токен — одинаковые.
3. Переключить etcd на восстановленные данные
Подмените каталог данных (в манифесте статического пода или перемещением каталогов): /var/lib/etcd → восстановленный /var/lib/etcd-restore. Верните манифесты в /etc/kubernetes/manifests/.
4. Проверить
etcdctl endpoint health --cluster -w table ...
kubectl get nodes
kubectl get pods --all-namespacesРекомендации по надёжности
| Область | Рекомендация |
|---|---|
| Диски | Только быстрые SSD/NVMe с низкой задержкой записи (fsync). Медленный диск — причина №1 нестабильности etcd: таймауты, смены лидера, «флап» кластера |
| Сеть | Между узлами etcd — низкие и стабильные RTT, желательно в пределах одного региона. Джиттер сети влияет на выборы лидера |
| Размещение | Три узла — в трёх разных доменах отказа (стойки, зоны доступности), иначе авария одной зоны унесёт кворум |
| Ресурсы | Выделенные CPU и память для etcd; на stacked-узлах защищайте etcd от конкуренции через QoS и приоритеты |
| Мониторинг | Метрики etcd (через Prometheus): etcd_server_has_leader, задержки fsync и предложений, размер БД, число смен лидера |
| Бэкапы | Регулярные снапшоты + хранение вне кластера + репетиция восстановления |
| Версии | Держите etcd в поддерживаемой версии, обновляйте планово и по одному узлу |
| Шифрование | Включите EncryptionConfiguration в apiserver для шифрования Secret в etcd |
wal_fsync_duration_seconds и backend_commit_duration_seconds: задержки записи выше десятков миллисекунд — тревожный сигнал.
TLS в etcd
Весь трафик etcd защищён взаимным TLS: есть два независимых канала — client (порт 2379, сюда ходит apiserver) и peer (порт 2380, между узлами etcd). В стандартной установке kubeadm для них генерируются отдельные сертификаты в /etc/kubernetes/pki/etcd/. Практические следствия:
- команды
etcdctlбез сертификатов не пройдут — всегда указывайте--cacert/--cert/--key; - следите за сроком действия сертификатов: просроченный peer-сертификат разваливает кластер etcd;
- при обновлении кластера через kubeadm сертификаты продлеваются автоматически.
Ключевые метрики для мониторинга
| Метрика | О чём говорит | Тревожный признак |
|---|---|---|
etcd_server_has_leader |
Есть ли у узла лидер | 0 — узел не видит лидера, кворум под угрозой |
etcd_server_leader_changes_seen_total |
Число смен лидера | Частые смены — нестабильность сети или дисков |
etcd_disk_wal_fsync_duration_seconds |
Задержка фиксации WAL | Рост 99-го перцентиля — медленный или перегруженный диск |
etcd_disk_backend_commit_duration_seconds |
Задержка записи в backend | Устойчивый рост — деградация дисковой подсистемы |
etcd_mvcc_db_total_size_in_bytes |
Размер базы | Приближение к квоте (по умолчанию 2 ГБ) — риск аларма NOSPACE |
etcd_network_peer_round_trip_time_seconds |
RTT между узлами etcd | Рост — проблемы сети между площадками control plane |
Частые проблемы и их первопричины
| Симптом | Вероятная причина | Первое действие |
|---|---|---|
| Постоянные смены лидера | Медленный диск, джиттер сети | Смотреть метрики fsync и RTT |
| apiserver «тормозит», таймауты | Перегруженный etcd или большие листинги | Проверить endpoint status, размер БД |
| Аларм NOSPACE | База уперлась в квоту | Компакция → дефрагментация → disarm |
| Узел etcd не входит в кластер | Просроченные сертификаты, повреждённые данные | Проверить сроки сертификатов и логи узла |
Обслуживание: дефрагментация и алармы
etcd — это база с многоверсионностью: каждое изменение создаёт новую ревизию, а старые версии ключей копятся, пока их не удалить. Отсюда две рутинные процедуры.
Компакция
Удаляет старые ревизии. Kubernetes сам делает компакцию через apiserver (по умолчанию каждые 5 минут) — вручную обычно вмешиваться не нужно, но полезно понимать механизм:
# вручную: скомпактировать до ревизии N
etcdctl compact <revision> \
  --endpoints=127.0.0.1:2379 --cacert=... --cert=... --key=...
Дефрагментация
Компакция удаляет данные логически, но файл базы на диске не уменьшается — освобождённые страницы просто помечаются свободными. Дефрагментация физически переписывает базу и возвращает место:
# дефрагментируем каждый член кластера по очереди (лидера — последним!)
etcdctl defrag --cluster \
  --endpoints=127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
--key=/etc/kubernetes/pki/etcd/server.keyАлармы
Если база приближается к лимиту (по умолчанию 2 ГБ), etcd включает режим защиты: аларм NOSPACE запрещает все записи, пока не выполнены компакция и дефрагментация. После устранения причины аларм снимают:
# посмотреть активные алармы
etcdctl alarm list --endpoints=... --cacert=... --cert=... --key=...

# после compact + defrag снять аларм
etcdctl alarm disarm --endpoints=... --cacert=... --cert=... --key=...
Мониторинг etcd
etcd деградирует не внезапно: сначала растут задержки, потом начинаются перевыборы лидера, и только затем кластер «рассыпается». Правильный мониторинг показывает проблему на первом этапе, когда её ещё легко исправить. etcd отдаёт метрики в формате Prometheus на endpoint'е /metrics — их забирает тот же стек, что описан в разделе «Мониторинг».
Ключевые метрики
| Метрика | Что показывает | Тревожный признак |
|---|---|---|
etcd_disk_wal_fsync_duration_seconds |
Задержка fsync журнала WAL: сколько etcd ждёт подтверждения записи на диск | p99 устойчиво выше десятков миллисекунд — диск медленный или конкурирует за I/O |
etcd_disk_backend_commit_duration_seconds |
Время фиксации транзакций в основной базе | Рост вместе с fsync — просела дисковая подсистема узла |
etcd_mvcc_db_total_size_in_bytes |
Физический размер файла базы на диске | Приближение к лимиту (по умолчанию 2 ГБ) — пора компактизировать и дефрагментировать |
etcd_server_leader_changes_seen_total |
Счётчик смен лидера | Любые приращения вне плановых работ: лидер «мигает» из-за сети или перегрузки |
etcd_server_has_leader |
Есть ли у члена кластера лидер прямо сейчас | Значение 0 на любом узле — кластер временно без лидера и не принимает записи |
etcd_network_peer_round_trip_time_seconds |
Время оборота сообщения между членами etcd | Рост указывает на проблемы сети между узлами control plane |
Проверка состояния командами
Помимо метрик, первичная диагностика делается утилитой etcdctl (сертификаты указаны для типовой установки kubeadm):
# статус каждого endpoint'а: размер БД, версия, лидер ли это
etcdctl endpoint status --cluster -w table \
  --endpoints=127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key

# живость каждого endpoint'а
etcdctl endpoint health --cluster \
  --endpoints=127.0.0.1:2379 --cacert=... --cert=... --key=...

# активные алармы (в идеале — пусто)
etcdctl alarm list \
  --endpoints=127.0.0.1:2379 --cacert=... --cert=... --key=...
Лимит размера базы и компактизация
По умолчанию размер базы etcd ограничен 2 ГБ (параметр --quota-backend-bytes, максимально разумное значение — 8 ГБ). При приближении к лимиту etcd включает защитный аларм NOSPACE и запрещает записи — кластер Kubernetes при этом становится «только для чтения». Порядок действий знаком из раздела про обслуживание: убедиться, что apiserver выполняет компакцию ревизий, выполнить дефрагментацию по одному узлу (лидера — последним), затем снять аларм командой etcdctl alarm disarm.
Профилактика проста: следите за etcd_mvcc_db_total_size_in_bytes и настройте алерт на подход к квоте. Регулярная компакция, которую apiserver делает по умолчанию каждые 5 минут, не даёт базе расти бесконечно, но физическое место возвращает только дефрагментация.
Признаки деградации
- Растёт fsync latency при неизменной нагрузке — диск изнашивается или делится I/O с посторонними процессами.
- Частые смены лидера — классический симптом сетевых проблем или перегруженного узла; apiserver при этом начинает отвечать таймаутами.
- Размер базы растёт быстрее обычного — где-то «мусорный» объектный шум: частые обновления огромных ConfigMap, бесконтрольные события или сломанный контроллер, пишущий в цикле.
- Один узел хронически отстаёт (raft index ниже остальных в endpoint status) — проблемный диск или сеть конкретной машины; такой узел лучше вывести и заменить.
Итог
etcd — компактный, но фундаментальный компонент: весь Kubernetes стоит на его консистентности. Запомните главное: нечётное число узлов, быстрые диски, три зоны отказа, регулярные проверенные снапшоты — и control plane вашего кластера переживёт почти любую аварию.