
Наблюдаемость в Kubernetes
Кластер, в котором не видно, что происходит, — это ящик с сюрпризами. В этом разделе мы соберём наблюдаемость с нуля: от простого kubectl top до полноценного стека Prometheus + Grafana с дашбордами, логирования и алертинга. Все шаги воспроизводятся в локальном кластере из раздела «Локальная установка».
Три столпа наблюдаемости
Наблюдаемость (observability) — способность ответить на вопрос «что сейчас происходит с системой и почему». Классически она опирается на три типа сигналов:
| Сигнал | Что даёт | Инструменты в экосистеме k8s |
|---|---|---|
| Метрики | Числовые ряды во времени: потребление CPU и памяти, число запросов, задержки. Дёшево хранить, идеальны для дашбордов и алертов. | metrics-server, Prometheus, Grafana |
| Логи | Текстовые события приложений и компонентов кластера: ошибки, трассировки запросов, действия системы. | kubectl logs, Loki, Fluent Bit |
| Трейсинг | Путь одного запроса через цепочку сервисов: где именно потеряно время. | OpenTelemetry, Jaeger, Tempo |
Трейсинг нужен на зрелом этапе; первые два столпа обязательны с самого начала. Именно им посвящён этот раздел.
metrics-server и kubectl top
metrics-server — легковесный агрегатор ресурсоёмкости: он собирает с kublet каждого узла потребление CPU и памяти подами и узлами и отдаёт эти данные через стандартный Metrics API. Именно его используют команда kubectl top и автомасштабировщик HPA (см. раздел «Продвинутый уровень»).
Установка
# в minikube metrics-server включается одной командой
minikube addons enable metrics-server

# в других кластерах — официальный манифест
kubectl apply -f https://github.com/kubernetes-sigs/metrics-server/releases/latest/download/components.yaml

# проверяем, что под запустился
kubectl get pods -n kube-system | grep metrics-server
Использование
# потребление узлов
kubectl top nodes

# потребление подов во всех namespace
kubectl top pods --all-namespaces

# конкретный namespace, с разбивкой по контейнерам
kubectl top pods -n default --containersPrometheus и Grafana: kube-prometheus-stack
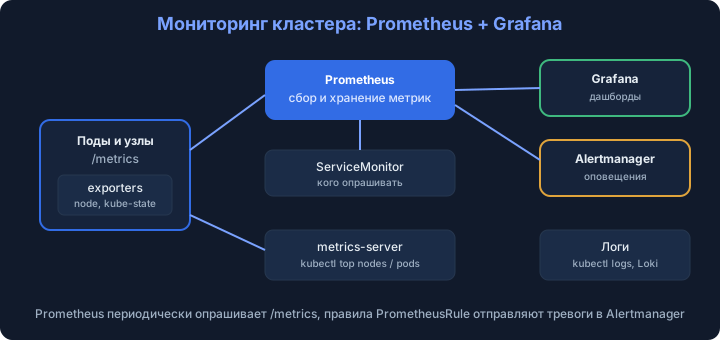
Prometheus — стандарт де-факто для метрик в Kubernetes: он сам обнаруживает цели в кластере, регулярно опрашивает их и хранит ряды метрик с мощным языком запросов PromQL. Grafana рисует по этим данным дашборды. Ставить их по частям необязательно: сообщество собрало готовый набор kube-prometheus-stack — Helm-чарт, который одной командой разворачивает Prometheus, Grafana, Alertmanager, экспортёры и десятки готовых дашбордов и правил.
Установка через Helm
Helm должен быть установлен (см. раздел «Продвинутый уровень»). Дальше — три команды:
# добавить репозиторий чартов prometheus-community
helm repo add prometheus-community https://prometheus-community.github.io/helm-charts
helm repo update

# установить стек в отдельный namespace monitoring
helm install monitoring prometheus-community/kube-prometheus-stack \
  --namespace monitoring --create-namespace

# смотрим, что развернулось
kubectl get pods -n monitoring
Через пару минут в namespace monitoring поднимутся Prometheus, Grafana, Alertmanager, node-exporter (метрики узлов) и kube-state-metrics (метрики объектов кластера: деплойменты, поды, их состояния).
Доступ к Grafana
# проброс порта на локальную машину
kubectl port-forward svc/monitoring-grafana 3000:80 -n monitoring

# Grafana открывается на http://localhost:3000
# логин: admin; пароль извлекаем из секрета:
kubectl get secret monitoring-grafana -n monitoring \
  -o jsonpath="{.data.admin-password}" | base64 -d
Базовые дашборды
Главное достоинство стека — дашборды уже настроены. В Grafana откройте раздел Dashboards и найдите группу Kubernetes:
| Дашборд | Что показывает |
|---|---|
| Kubernetes / Compute Resources / Cluster | Потребление CPU и памяти всего кластера против запросов и лимитов |
| Kubernetes / Compute Resources / Namespace (Pods) | Ресурсоёмкость подов выбранного namespace |
| Kubernetes / Compute Resources / Pod | Детализация по одному поду и его контейнерам |
| Kubernetes / API server | Здоровье apiserver: частота и задержки запросов, коды ответов |
| Node Exporter / Nodes | Системные метрики узлов: диск, сеть, load average |
minikube start --memory=4096 --cpus=2) — иначе поды мониторинга вытеснят ваши учебные приложения.
Как Prometheus узнаёт, что опрашивать
Prometheus не хранит статический список адресов: он сам обнаруживает цели через API Kubernetes. В kube-prometheus-stack обнаружение описывается CRD-объектом ServiceMonitor: вы указываете селектор сервисов и порт — оператор превращает это в конфигурацию сбора. Чтобы Prometheus начал снимать метрики с вашего приложения, достаточно двух условий: приложение отдаёт метрики на HTTP-endpoint'е (обычно /metrics) и для его Service создан такой манифест:
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: myapp
  namespace: monitoring        # сам монитор живёт в monitoring...
spec:
  namespaceSelector:
    matchNames: [default]      # ...а смотрит на сервисы из default
  selector:
    matchLabels:
      app: myapp               # метка Service вашего приложения
  endpoints:
    - port: http               # имя порта в Service
interval: 30s # как часто опрашиватьhttp_requests_total{handler="/api",code="200"} 1523. Для всех популярных языков есть клиентские библиотеки, которые сами формируют такой ответ и уже содержат стандартные метрики рантайма.
Первые запросы PromQL
В веб-интерфейсе Prometheus (проброс: kubectl port-forward svc/monitoring-kube-prometheus-prometheus 9090:9090 -n monitoring) данные исследуются языком PromQL. Пять запросов для первого знакомства:
| Запрос | Что показывает |
|---|---|
kube_pod_status_phase{phase="Failed"} |
Поды в состоянии Failed по всему кластеру |
rate(container_cpu_usage_seconds_total[5m]) |
Потребление CPU контейнерами, усреднённое за 5 минут |
container_memory_working_set_bytes |
Фактическое потребление памяти контейнерами |
kube_pod_container_status_restarts_total |
Накопленный счётчик перезапусков каждого контейнера |
node_filesystem_avail_bytes |
Свободное место на файловых системах узлов |
Те же запросы лежат в основе готовых дашбордов Grafana и правил алертинга — PromQL является единым языком всего стека.
Логирование: kubectl logs и Loki
Базовый уровень: kubectl logs
Логи контейнеров Kubernetes пишет в stdout/stderr, а читает их kubectl logs:
# логи пода (если контейнер один)
kubectl logs web

# следить за логами в реальном времени
kubectl logs -f web

# последние 100 строк и логи предыдущего (упавшего) контейнера
kubectl logs web --tail=100
kubectl logs web --previous

# логи всех реплик деплоймента разом (по метке)
kubectl logs -l app=web --tail=20
Этого достаточно для ручной отладки, но у подхода есть предел: логи живут, пока жив под, узел ротирует их файлы, а по поиску «в какой из тридцати реплик была ошибка вчера ночью» kubectl logs бессилен. Нужна централизованная система.
Обзор Loki
Loki — система сбора логов от автора Grafana, спроектированная по мотивам Prometheus: вместо полной индексации текста она индексирует только метки (namespace, под, контейнер), а сам текст хранит компактно. Благодаря этому Loki заметно легче классических стеков на базе Elasticsearch и естественно интегрируется с Grafana: логи открываются рядом с метриками в том же интерфейсе.
Типовой конвейер выглядит так: на каждом узле агент (обычно Promtail или Fluent Bit в виде DaemonSet) читает файлы логов контейнеров, обогащает их метками Kubernetes и отправляет в Loki. В Grafana добавляется источник данных Loki — и вы фильтруете логи запросами вида {namespace="default", app="web"}, переходя от графика ошибок к строкам логов в пару щелчков.
Установка минимального стенда Loki тоже делается через Helm:
# репозиторий чартов Grafana
helm repo add grafana https://grafana.github.io/helm-charts
helm repo update

# Loki + Promtail в тот же namespace monitoring
helm install loki grafana/loki -n monitoring
helm install promtail grafana/promtail -n monitoring \
  --set "config.clients[0].url=http://loki.monitoring.svc.cluster.local:3100/loki/api/v1/push"

# убеждаемся, что агенты запустились на всех узлах
kubectl get pods -n monitoring -l app.kubernetes.io/name=promtail -o wide
После этого в Grafana (раздел Connections → Data sources) добавляется источник типа Loki с адресом http://loki.monitoring:3100 — и логи всех подов становятся доступны для поиска в разделе Explore.
Алертинг: Alertmanager и PrometheusRule
Мониторинг без алертов — это телевизор, за которым кто-то должен непрерывно смотреть. Правильная схема обратная: система сама сообщает о проблемах. В стеке kube-prometheus за это отвечают два компонента:
- Prometheus вычисляет правила алертинга и при срабатывании отправляет сигнал;
- Alertmanager принимает сигналы, группирует их, гасит дубликаты и рассылает уведомления по каналам (почта, мессенджеры, системы инцидентов).
Правила в виде кода: PrometheusRule
kube-prometheus-stack приносит с собой CRD PrometheusRule — алерты описываются обычными манифестами Kubernetes и версионируются в git вместе с приложением. Пример простого правила — сообщить, если под перезапускается слишком часто:
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: pod-restarts
  namespace: monitoring
spec:
  groups:
    - name: availability
      rules:
        - alert: PodRestartingTooOften
          expr: |
            increase(kube_pod_container_status_restarts_total[15m]) > 5
          for: 5m                # срабатывает, если условие держится 5 минут
          labels:
            severity: warning
          annotations:
            summary: "Под {{ $labels.pod }} перезапустился больше 5 раз за 15 минут"
Примените манифест — и правило появится в Prometheus без перезапуска, а сработавший алерт будет виден в веб-интерфейсе Alertmanager:
kubectl apply -f prometheusrule.yaml

# проброс интерфейса Alertmanager
kubectl port-forward svc/monitoring-kube-prometheus-alertmanager 9093:9093 -n monitoring
Alertmanager настраивается декларативно: дерево маршрутов решает, какие алерты куда отправлять (по метке severity, namespace, команде), а приёмники описывают каналы доставки — почту, вебхуки, мессенджеры. Две его возможности особенно важны в реальной эксплуатации: группировка (сто одинаковых алертов с реплик одного сервиса приходят одним уведомлением) и ингибирование (алерт «кластер недоступен» подавляет сотню нижележащих симптомов — незачем будить команду сто раз об одном и том же).
Практикум: от алерта до причины за пять минут
Соберём всё вышесказанное в единый сценарий расследования — именно так проходит типовой инцидент в кластере с настроенной наблюдаемостью:
1. Алерт сообщил о симптоме
Alertmanager прислал уведомление: «Под web перезапустился больше 5 раз за 15 минут». Само уведомление — только точка входа: оно отвечает на вопрос «где болит», но не «почему».
2. Метрики показывают масштаб
В Grafana открываем дашборд Kubernetes / Compute Resources / Pod для этого пода: видно, что перед каждым рестартом потребление памяти упирается в лимит. Гипотеза — OOMKilled.
3. События и состояние подтверждают
kubectl describe pod <имя>   # в Last State видно: Reason: OOMKilled
kubectl get pod <имя> -o yaml | grep -A5 lastState
4. Логи раскрывают причину
# логи предыдущего воплощения контейнера
kubectl logs <имя> --previous --tail=100

# или тот же контекст через Loki в Grafana Explore:
# {namespace="default", pod="web-xxxxx"} |= "OutOfMemory"
В логах — утечка при обработке большого запроса. Причина найдена, лимит памяти поднят как временная мера, задача на исправление заведена.
На что смотреть в первую очередь
Метрик в кластере тысячи, но дежурный набор, который стоит проверять при любом подозрении на проблему, невелик:
| Метрика / сигнал | Где смотреть | О чём говорит |
|---|---|---|
| Поды не в Running / растёт счётчик рестартов | kubectl get pods, дашборд Kubernetes / Compute Resources |
Падения приложения, нехватка памяти (OOMKilled), ошибки в пробах |
| CPU/память подов против requests и limits | kubectl top pods, Grafana |
Приложение упирается в лимит (троттлинг, OOM) или ресурсы занижены |
| Свободное место на дисках узлов | Node Exporter / Nodes | Заполнение диска — частая причина вытеснения подов и остановки узла |
| Состояние узлов (Ready / NotReady) | kubectl get nodes, kube-state-metrics |
Потеря узла ведёт к массовой миграции подов и просадке ёмкости |
| Частота и задержки запросов к apiserver | Дашборд Kubernetes / API server | Здоровье самого кластера: перегруженный apiserver тормозит всё управление |
| Ошибки приложений (5xx, exceptions) | Метрики приложения, логи через Loki | Проблема уже дошла до пользователей — повод для алерта первого приоритета |
kubectl top; развернуть kube-prometheus-stack и открыть дашборд кластера в Grafana; прочитать логи упавшего пода через --previous; написать одно правило PrometheusRule. С этим набором вы наблюдаете за кластером лучше, чем иные «боевые» установки без мониторинга вообще. Кстати, у etcd — хранилища состояния кластера — есть свои критичные метрики; им посвящён раздел «etcd».