
Сети в Kubernetes
Сеть — самая «невидимая» и самая важная часть кластера: пока она работает, её никто не замечает, а когда ломается — не работает ничего. Разберём фундаментальную сетевую модель Kubernetes, плагины CNI, механику kube-proxy, сетевые политики и встроенный DNS.
Почему это важно знать досконально: абсолютное большинство инцидентов в Kubernetes-кластерах имеет сетевую природу или сетевые симптомы. Инженер, понимающий сетевую модель, диагностирует проблему в разы быстрее.
Сетевая модель: три правила
Kubernetes предъявляет к сети три жёстких требования — они определены в спецификации и выполняются любой корректной реализацией:
- Каждый под получает собственный уникальный IP-адрес. Под видит свой IP точно так же, как видят его остальные — никакой трансляции адресов «внутри» и «снаружи».
- Поды могут общаться со всеми подами на всех узлах без NAT. Под на узле А напрямую достучится до пода на узле Б по его адресу.
- Узлы могут общаться со всеми подами без NAT. И наоборот.
Результат — «плоская» сеть: приложение в контейнере не думает о том, где физически находится собеседник. Это радикально упрощает перенос приложений с виртуальных машин: не нужно переписывать логику обнаружения сервисов и пробрасывать порты.
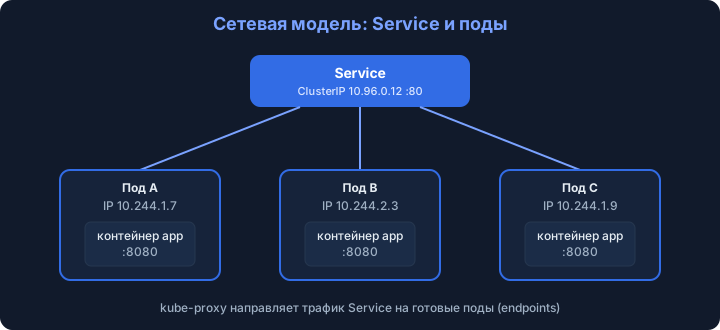
Диапазоны адресов
| Сущность | Откуда берутся адреса | Пример |
|---|---|---|
| Узлы | Сеть дата-центра или облака | 192.168.10.0/24 |
| Поды (podCIDR) | Выделенный кластерный диапазон, нарезается по узлам | 10.244.0.0/16 |
| Service (ClusterIP) | Отдельный виртуальный диапазон, существует только в правилах ядра | 10.96.0.0/12 |
CNI-плагины: Calico, Cilium, Flannel
Сама сетевая модель Kubernetes не реализует — за неё отвечает CNI-плагин (Container Network Interface). Когда kubelet создаёт под, он вызывает CNI, и тот выделяет IP, настраивает интерфейсы и маршруты. Плагинов много; рассмотрим три наиболее распространённых.
| Критерий | Flannel | Calico | Cilium |
|---|---|---|---|
| Технология | Overlay (VXLAN), простой backend host-gw | Без overlay (чистая маршрутизация, BGP) или VXLAN/IP-in-IP | eBPF в ядре Linux, overlay или native routing |
| Сложность | Минимальная | Средняя | Средняя и выше |
| NetworkPolicy | Нет (нужен дополнительный компонент) | Да, плюс расширенные политики Calico | Да, включая L7-политики (HTTP, Kafka, DNS) |
| Производительность | Достаточная для учебных и небольших кластеров | Высокая в режиме без overlay | Очень высокая за счёт eBPF, обход части путей ядра |
| Наблюдаемость | Базовая | Логи политик, интеграции | Hubble — визуализация потоков L3–L7 |
| Типичное применение | Домашние лаборатории, старт | Enterprise, on-premise, гибрид | Высоконагруженные кластеры, безопасность, observability |
Calico
Зрелый проект с богатой историей. Главная сила — гибкость: может работать без инкапсуляции, анонсируя маршруты подов по BGP прямо в сеть дата-центра (тогда поды доступны извне кластера как обычные хосты), либо в overlay-режиме поверх любой сети. Поддерживает собственные расширенные политики GlobalNetworkPolicy и интеграцию с Istio.
Cilium
Лидер новой волны CNI, построен на технологии eBPF: программы выполняются прямо в ядре Linux, поэтому балансировка, политики и наблюдаемость работают с минимальными накладными расходами. Cilium умеет заменять kube-proxy целиком (режим kube-proxy replacement), фильтровать трафик на уровне HTTP-методов и путей (L7), а компонент Hubble даёт наглядную карту сетевых потоков.
Flannel
Самый простой плагин: настраивает overlay-сеть по VXLAN и больше ничего. Никаких NetworkPolicy, минимум настроек. Отличный выбор, чтобы «просто заработало» в лаборатории; для production с требованиями к сегментации его обычно недостаточно.
Помимо этих трёх существуют и другие реализации CNI — включая облачные (у managed k8s провайдер часто предлагает собственный сетевой слой) и специализированные. Общий принцип выбора неизменен: сначала требования к политикам и производительности, потом конкретный плагин.
Метрики kube-proxy (тип, количество правил, ошибки синхронизации) доступны через Prometheus-эндпоинт компонента — в production-наблюдении за кластером они входят в стандартный набор.
kube-proxy: как на самом деле работает Service
Service с типом ClusterIP получает виртуальный IP, которому не соответствует никакой сетевой интерфейс. Магию исполняет kube-proxy — агент на каждом узле, который следит за объектами Service и Endpoints и программирует правила ядра Linux.
Посмотреть, какие правила kube-proxy создал на узле, можно командами iptables -t nat -L KUBE-SERVICES (в режиме iptables) или ipvsadm -Ln (в режиме IPVS) — это лучший способ «потрогать» механику сервисов руками в учебном кластере.
Режимы работы kube-proxy
| Режим | Механика | Особенности |
|---|---|---|
iptables (по умолчанию) |
Цепочки правил iptables перебрасывают трафик с ClusterIP на случайный живой под | Надёжен, повсеместен; на тысячах сервисов список правил растёт линейно |
ipvs |
Балансировка через подсистему IPVS ядра (хеш-таблицы) | Быстрее на большом числе сервисов; несколько алгоритмов балансировки (rr, lc, sh...) |
nftables |
Правила на современной подсистеме nftables | Новый режим, пришёл на смену iptables в свежих версиях k8s |
| Без kube-proxy | Балансировку берёт на себя CNI (например, Cilium на eBPF) | Максимальная производительность, меньше правил ядра |
Поток выглядит так: приложение обращается к 10.96.0.10:80 (ClusterIP сервиса) — правила на узле подменяют назначение на IP одного из подов, например 10.244.2.17:8080 — пакет уходит через сеть кластера на нужный узел. Под видит обычное входящее соединение.
sessionAffinity: ClientIP — тогда выбор пода фиксируется по IP клиента на заданное время.
Headless-сервисы
Особый вид Service — headless (clusterIP: None). У него нет виртуального IP: DNS возвращает сразу список IP всех подов селектора. Это нужно, когда клиент сам выбирает конкретный экземпляр: реплики СУБД, узлы кластера Kafka, члены кворума. Именно headless-сервис даёт подам StatefulSet стабильные DNS-имена вида pod-0.svc-name.ns.svc.cluster.local.
Север-юг и восток-запад
При проектировании сети кластера трафик принято делить на два направления:
| Направление | Что это | Инструменты |
|---|---|---|
| Север-юг (north-south) | Трафик между внешним миром и кластером | Ingress-контроллер, LoadBalancer, NodePort, Gateway API |
| Восток-запад (east-west) | Трафик между подами и сервисами внутри кластера | ClusterIP, headless-сервисы, NetworkPolicy, service mesh |
У направлений разные требования: север-юг — про TLS, маршрутизацию и WAF, восток-запад — про сегментацию, наблюдаемость и низкие задержки.
NetworkPolicy — брандмауэр для подов
По умолчанию в кластере действует принцип «всем всё можно»: любой под может открыть соединение к любому поду. Для production это неприемлемо. NetworkPolicy — стандартный объект Kubernetes, описывающий, какой трафик разрешён к выбранным подам (ingress) и от них (egress). Исполняет политики CNI-плагин: сам по себе манифест ничего не фильтрует — нужен Calico, Cilium или другой плагин с поддержкой политик.
Ключевые свойства
- Политика выбирает поды через
podSelector— по меткам, как всё в Kubernetes. - Как только к поду применена хотя бы одна политика ingress, весь не разрешённый входящий трафик к нему запрещён. Аналогично для egress.
- Правила могут ссылаться на поды (
podSelector), namespace (namespaceSelector) или IP-блоки (ipBlock), и на порты. - Политики складываются: разрешено то, что разрешила хотя бы одна из применимых политик.
Шаг 1. Политика «запретить всё» в namespace
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny-all
  namespace: team-payments
spec:
  podSelector: {}            # пустой селектор = все поды namespace
  policyTypes:
    - Ingress
    - Egress
После её применения в namespace наступает «тишина»: никакой трафик не проходит. Дальше разрешаем только нужное — принцип белого списка.
Шаг 2. Разрешить DNS всем подам
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-dns
  namespace: team-payments
spec:
  podSelector: {}
  policyTypes:
    - Egress
  egress:
    - to:
        - namespaceSelector:
            matchLabels:
              kubernetes.io/metadata.name: kube-system
      ports:
        - port: 53
          protocol: UDP
        - port: 53
          protocol: TCP
Шаг 3. Разрешить фронтенду доступ к бэкенду, а бэкенду — к базе
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-frontend-to-backend
  namespace: team-payments
spec:
  podSelector:
    matchLabels:
      app: backend          # политика охраняет поды backend
  policyTypes:
    - Ingress
  ingress:
    - from:
        - podSelector:       # принимать только от подов frontend
            matchLabels:
              app: frontend
      ports:
        - port: 8080
          protocol: TCP
---
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-backend-to-db
  namespace: team-payments
spec:
  podSelector:
    matchLabels:
      app: postgres
  policyTypes:
    - Ingress
  ingress:
    - from:
        - podSelector:
            matchLabels:
              app: backend
      ports:
        - port: 5432
protocol: TCPCoreDNS — служба имён кластера
За разрешение имён внутри кластера отвечает CoreDNS — он работает как обычный Deployment в namespace kube-system и принимает запросы через Service kube-dns. Kubelet при создании пода прописывает ему в /etc/resolv.conf адрес этого сервиса — поэтому все контейнеры автоматически пользуются кластерным DNS.
Тонкость: у каждого пода в /etc/resolv.conf настроен список суффиксов поиска (ndots: 5 по умолчанию), поэтому короткое имя web-service из своего namespace сначала дополняется суффиксами кластера. Это удобно, но при обращениях к внешним доменам порождает лишние DNS-запросы; в высоконагруженных системах внешние имена пишут с точкой в конце (FQDN), чтобы обойти перебор суффиксов.
Какие имена создаются автоматически
| Объект | DNS-имя |
|---|---|
| Service (обычный) | имя.namespace.svc.cluster.local |
| Service (короткие формы из того же namespace) | имя, имя.namespace |
| Под StatefulSet через headless-сервис | под-0.сервис.namespace.svc.cluster.local |
| Под (по запросу, редко) | ip-с-дефисами.namespace.pod.cluster.local |
Corefile — конфигурация CoreDNS
Настройки CoreDNS живут в ConfigMap coredns в kube-system. Типичный Corefile:
.:53 {
    errors                # логировать ошибки
    health {              # endpoint проверки живости
       lameduck 5s
    }
    ready                 # endpoint готовности
    kubernetes cluster.local in-addr.arpa ip6.arpa {
       pods insecure
       fallthrough in-addr.arpa ip6.arpa
       ttl 30
    }
    prometheus :9153      # метрики для Prometheus
    forward . /etc/resolv.conf {   # внешние имена — вышестоящему DNS
       max_concurrent 1000
    }
    cache 30              # кеш ответов, секунд
    loop                  # защита от петель форвардинга
    reload                # подхватывать изменения ConfigMap
    loadbalance           # перемешивать A-записи
}
Благодаря плагинной архитектуре Corefile легко расширяется: можно, например, добавить статические записи (плагин hosts) или разделить зоны между окружениями.
Путь пакета: от пользователя до контейнера
Соберём всё изученное в единую картину. Запрос пользователя к приложению, опубликованному через Ingress, проходит такой путь:
- Внешний DNS указывает домен на IP балансировщика или узла кластера.
- Балансировщик / NodePort доставляет трафик на один из узлов, где работает ingress-контроллер.
- Ingress-контроллер терминирует TLS, смотрит host и path и по своим правилам выбирает Service.
- Правила kube-proxy (или eBPF) на узле перенаправляют соединение с ClusterIP сервиса на IP конкретного пода.
- Сеть CNI доставляет пакет на узел, где живёт под (через overlay или прямую маршрутизацию).
- NetworkPolicy на пути проверяет, разрешён ли такой трафик.
- Контейнер принимает соединение на свой
containerPort— обычный TCP, без магии.
Ответ идёт в обратную сторону. Каждый из этих шагов — отдельная подсистема с собственными логами и метриками, поэтому диагностику всегда ведут по цепочке, двигаясь от точки, где трафик теряется.
Диагностика сетевых проблем
Алгоритм «от общего к частному», когда «сервис недоступен»:
1. Живы ли поды?
kubectl get pods -n <ns> -o wide
kubectl describe pod <имя> -n <ns>   # события и пробы
2. Есть ли endpoints у сервиса?
kubectl get endpoints <service> -n <ns>Пустой список endpoints — классика: селектор Service не совпадает с метками подов. Сверьте selector сервиса и labels подов.
3. Резолвится ли имя?
kubectl run tmp --rm -it --image=busybox:1.36 -- sh
# внутри контейнера:
nslookup <service>.<ns>.svc.cluster.local
wget -qO- <service>:<port>
4. Не мешает ли NetworkPolicy?
kubectl get networkpolicies -n <ns>Если политики есть — проверьте, разрешают ли они нужную пару «источник → назначение» и DNS.
5. Работает ли маршрутизация между узлами?
Проверьте поды CNI-плагина (обычно DaemonSet в kube-system): они должны быть Running на всех узлах, а их логи — без ошибок.
6. Зафиксируйте выводы
Документируйте найденную причину и способ починки: короткая заметка в базе знаний команды превращает разовое расследование в накопленную экспертизу. Через несколько таких заметок у вас будет собственная сетевая шпаргалка, заточенная под ваш кластер.
busybox, nicolaka/netshoot и подобные содержат весь арсенал диагностики: nslookup, dig, curl, tcpdump, traceroute. Один такой отладочный под экономит часы расследований.
Практикум диагностики сети
Закрепим раздел практикой: разыграем полное расследование «сервис недоступен» в учебном кластере. Все команды выполняются с рабочей машины и из временного отладочного пода.
1. Запустить отладочный под
# одноразовый под с busybox: удалится сам после выхода
kubectl run debug --rm -it --image=busybox:1.36 -- sh

# если нужен полный арсенал: dig, curl, tcpdump, traceroute
kubectl run debug --rm -it --image=nicolaka/netshoot -- bash
Под окажется внутри кластерной сети и увидит её так, как видят ваши приложения, — это и есть главная ценность приёма: вы диагностируете сеть «изнутри», а не снаружи.
2. Проверить DNS
# внутри отладочного пода:
nslookup kubernetes.default.svc.cluster.local   # резолвится ли вообще что-то
nslookup web-service                            # короткое имя в том же namespace
nslookup web-service.default.svc.cluster.local  # полное имя

# с хоста — состояние самого CoreDNS:
kubectl get pods -n kube-system -l k8s-app=kube-dns
kubectl logs -n kube-system -l k8s-app=kube-dns --tail=50
Если nslookup не отвечает, проблема почти наверняка в CoreDNS или в том, что NetworkPolicy перекрыла порт 53. Если имя резолвится, но соединение не устанавливается — DNS ни при чём, идём дальше по цепочке.
3. Проверить соединение с сервисом и endpoints
# внутри пода: доходит ли трафик до сервиса
wget -qO- web-service:80

# с хоста: есть ли живые получатели у сервиса
kubectl get endpoints web-service
kubectl describe service web-service
Пустой список endpoints означает, что селектор Service не совпадает с метками подов — самая частая причина «недоступности» вовсе не сетевая.
4. Проверить NetworkPolicy
# какие политики действуют в namespace
kubectl get networkpolicies
kubectl describe networkpolicy <имя>
Помните правило: как только под попал под хотя бы одну политику, всё неразрешённое для него запрещено. Проверьте три вещи: разрешён ли входящий трафик к поду-получателю, разрешён ли исходящий трафик от пода-источника и не забыт ли DNS (UDP/TCP 53 к kube-dns).
Типовые симптомы и причины
| Симптом | Вероятная причина | Первая проверка |
|---|---|---|
| Имя сервиса не резолвится | CoreDNS не работает или NetworkPolicy режет порт 53 | Поды CoreDNS в Running; политики namespace разрешают DNS |
| Имя резолвится, соединение висит | Пустые endpoints: селектор Service не совпал с метками подов | kubectl get endpoints — список не пуст |
| Соединение сброшено сразу | NetworkPolicy запрещает трафик; либо targetPort не туда смотрит | kubectl describe networkpolicy; порт в Service vs containerPort |
| Из одного namespace доступ есть, из другого нет | Политика с namespaceSelector пускает не всех |
Метки namespace: на них опирается селектор в ingress-правиле |
| Работает на одном узле, не работает на другом | Упал агент CNI-плагина на узле; неправила kube-proxy | Поды CNI (DaemonSet) Running на всех узлах; логи kube-proxy |
| Внешние запросы не доходят до Ingress | Ingress-контроллер не запущен или не опубликован наружу | Под контроллера в Running; Service контроллера имеет внешний адрес |
Итог
Сетевая модель Kubernetes строится на трёх китах: плоская сеть подов через CNI-плагин, виртуальные сервисы через kube-proxy (или eBPF) и CoreDNS для имён. NetworkPolicy превращает открытую сеть в сегментированную по принципу белого списка. Освоив эти темы, вы понимаете, как трафик доходит от пользователя до контейнера — а значит, можете и проектировать, и отлаживать.
Закрепите материал практикой: поднимите два пода в учебном кластере, проверьте связность между ними, примените политику default-deny и наблюдайте, как связь обрывается, а затем точечно разрешите её. Пятнадцать минут такого эксперимента стоят часа чтения.