
Основы Kubernetes
Этот раздел — фундамент всего сайта. Здесь мы разберём архитектуру кластера и пять ключевых объектов, с которыми вы будете работать каждый день: под, Deployment, Service, ConfigMap, Secret и пространства имён. Каждая тема — со схемами и готовыми YAML-манифестами.
Архитектура кластера
Кластер Kubernetes состоит из двух логических частей: control plane (управляющий слой) и рабочие узлы (worker nodes), на которых выполняются приложения. Узлом может быть физический сервер или виртуальная машина.
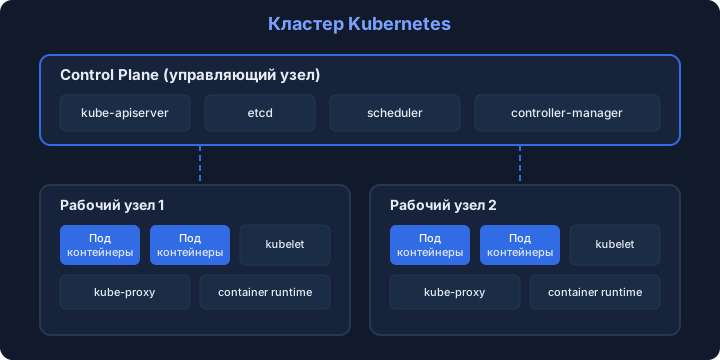
Компоненты control plane
| Компонент | Роль |
|---|---|
kube-apiserver |
Единственная точка входа в кластер. Все команды kubectl, запросы контроллеров и узлов проходят через REST API сервера. Выполняет аутентификацию, авторизацию и валидацию объектов. |
etcd |
Распределённое хранилище «ключ-значение», где лежит всё состояние кластера: объекты, конфигурации, секреты. Потеря etcd — потеря состояния кластера. Подробно разобрано в разделе «etcd». |
kube-scheduler |
Планировщик. Выбирает, на каком узле запустить каждый новый под, учитывая запросы ресурсов, ограничения, селекторы и правила сродства. |
kube-controller-manager |
Набор контроллеров в одном процессе: следят за состоянием объектов (ReplicaSet, Node, Job, ServiceAccount и других) и приводят фактическое состояние к желаемому. |
cloud-controller-manager |
Необязательный компонент для интеграции с облачным провайдером: создаёт балансировщики нагрузки, привязывает диски, управляет маршрутами узлов. |
Компоненты рабочего узла
| Компонент | Роль |
|---|---|
kubelet |
Агент на каждом узле. Получает от apiserver спецификации подов и следит, чтобы контейнеры были запущены и здоровы. Докладывает статус узла и подов. |
kube-proxy |
Настраивает сетевые правила на узле, благодаря которым работает механизм Service: трафик на виртуальный IP сервиса попадает на один из подов. Подробности — в разделе «Сети». |
| Container runtime | Среда исполнения контейнеров: containerd или CRI-O. Именно она скачивает образы и запускает контейнеры по указанию kubelet. |
Поды — минимальная единица
Под (pod) — самый маленький объект, которым оперирует Kubernetes. Это группа из одного или нескольких контейнеров, которые:
- всегда запускаются вместе на одном узле;
- разделяют одну сетевую среду — общий IP-адрес и пространство портов, общаются через
localhost; - могут совместно использовать тома (volumes) для обмена файлами;
- живут и умирают как единое целое: под нельзя перезапустить «наполовину».
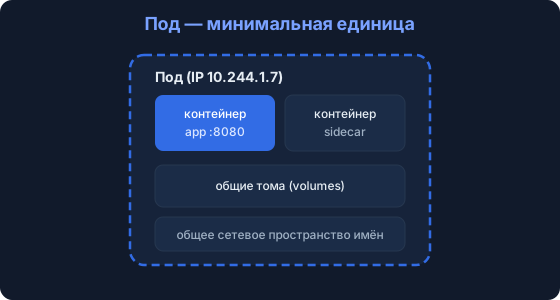
В подавляющем большинстве случаев в поде живёт ровно один контейнер — само приложение. Несколько контейнеров в поде нужны для тесно связанных помощников: сборщика логов, шлюза service mesh, агента обновления конфигурации (паттерны sidecar, ambassador, adapter).
Манифест простого пода
apiVersion: v1          # версия API для базовых объектов
kind: Pod               # тип объекта
metadata:
  name: web-pod         # имя пода, уникально в namespace
  labels:
    app: web            # метки — основа всех выборок в k8s
spec:
  containers:
    - name: nginx
      image: nginx:1.27  # всегда фиксируйте версию образа
      ports:
        - containerPort: 80
      resources:
        requests:      # сколько гарантированно нужно поду
          memory: "64Mi"
          cpu: "100m"   # 100 миллиядер = 0.1 CPU
        limits:        # выше этого потребления не подняться
          memory: "128Mi"
          cpu: "250m"
Применить манифест и посмотреть результат:
# создать объект из файла
kubectl apply -f pod.yaml

# список подов с указанием узла и IP
kubectl get pods -o wide

# подробное описание: события, состояние, ресурсы
kubectl describe pod web-pod

# логи контейнера внутри пода
kubectl logs web-pod
Жизненный цикл пода
| Фаза | Значение |
|---|---|
Pending |
Под принят кластером, но контейнеры ещё не запущены: идёт скачивание образа или планировщик ищет подходящий узел. |
Running |
Под привязан к узлу, хотя бы один контейнер работает (или перезапускается). |
Succeeded |
Все контейнеры завершились успешно — типично для разовых задач (Job). |
Failed |
Все контейнеры завершились, хотя бы один — с ошибкой. |
Unknown |
Состояние пода неизвестно: узел потерял связь с control plane. |
Deployments — управление репликами
На практике поды в чистом виде почти не создают: если такой под умрёт, никто его не восстановит. Вместо этого используют Deployment — контроллер, который:
- поддерживает заданное число одинаковых реплик (через промежуточный объект ReplicaSet);
- обеспечивает обновления без простоя — стратегия RollingUpdate постепенно заменяет старые поды новыми;
- хранит историю ревизий и позволяет откатиться на предыдущую версию одной командой;
- масштабируется в одну строчку — вручную или автоматически через HPA.
Манифест Deployment
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web
spec:
  replicas: 3             # три одинаковых пода
  selector:
    matchLabels:
      app: web          # какими подами управляет Deployment
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxSurge: 1        # на сколько подов можно превысить цель
      maxUnavailable: 0  # обновление без потери доступности
  template:              # шаблон пода
    metadata:
      labels:
        app: web
    spec:
      containers:
        - name: nginx
          image: nginx:1.27
          ports:
            - containerPort: 80
          readinessProbe:   # готов ли принимать трафик
            httpGet:
              path: /
              port: 80
            initialDelaySeconds: 5
            periodSeconds: 10
          livenessProbe:    # жив ли процесс вообще
            httpGet:
              path: /
              port: 80
            initialDelaySeconds: 15
            periodSeconds: 20
Поле selector.matchLabels жёстко связывает Deployment с шаблоном: он управляет всеми подами с меткой app: web. Проверки readinessProbe и livenessProbe — обязательный элемент зрелого манифеста: первая убирает неготовый под из балансировки, вторая перезапускает зависший контейнер.
Типовые операции с Deployment
# применить манифест
kubectl apply -f deployment.yaml

# обновить образ — начнётся rolling update
kubectl set image deployment/web nginx=nginx:1.28

# наблюдать за процессом обновления
kubectl rollout status deployment/web

# история ревизий и откат на предыдущую
kubectl rollout history deployment/web
kubectl rollout undo deployment/web

# масштабирование
kubectl scale deployment/web --replicas=5resources.requests и resources.limits у контейнеров. Без requests планировщик не сможет разумно размещать поды, а без limits один «прожорливый» под способен отнять память у всего узла и вытеснить соседей.
Services — доступ к приложениям
Поды рождаются и умирают, их IP-адреса меняются. Service — стабильная сетевая конечная точка перед группой подов: постоянный виртуальный IP, DNS-имя и встроенная балансировка трафика между репликами. Связь Service с подами определяется всё теми же метками (селектором).
Типы Service
| Тип | Доступность | Типичное применение |
|---|---|---|
ClusterIP |
Только внутри кластера (тип по умолчанию) | Внутренние сервисы: backend, базы данных, очереди |
NodePort |
Снаружи через порт 30000–32767 на каждом узле | Отладка, домашние лаборатории, простые установки |
LoadBalancer |
Внешний балансировщик облачного провайдера | Публикация сервисов в облаке |
ExternalName |
DNS-запись CNAME на внешнее имя | Указатели на сервисы вне кластера |
Манифест Service
apiVersion: v1
kind: Service
metadata:
  name: web-service
spec:
  type: ClusterIP
  selector:
    app: web            # тот же label, что и в Deployment
  ports:
    - port: 80          # порт самого Service
      targetPort: 80    # порт контейнера в поде
После создания любой под в кластере сможет обратиться к приложению по имени web-service — встроенный DNS (CoreDNS) разрешит его в виртуальный IP. Внутри другого namespace имя уточняется: web-service.default.svc.cluster.local.
kube-proxy на каждом узле программирует правила ядра (iptables, IPVS или nftables), которые перенаправляют трафик с виртуального IP сервиса на один из живых подов. Подробно об этом — в разделе «Сети».
ConfigMap и Secret — конфигурация приложений
Конфигурацию не принято «зашивать» в образ контейнера: один и тот же образ должен работать в тестовом и боевом окружении, меняется лишь конфигурация. Для этого есть два объекта:
- ConfigMap — обычные конфигурационные данные: строки, файлы настроек, флаги;
- Secret — чувствительные данные: пароли, токены, TLS-ключи. Хранятся в кодировке base64, их чтение ограничивается через RBAC, а в etcd можно включить шифрование.
Манифесты ConfigMap и Secret
apiVersion: v1
kind: ConfigMap
metadata:
  name: app-config
data:
  APP_MODE: "production"
  APP_LOG_LEVEL: "info"
  app.properties: |     # целый файл как значение
    timeout=30s
    cache.enabled=true
---
apiVersion: v1
kind: Secret
metadata:
  name: app-secret
type: Opaque
stringData:            # можно писать открытым текстом —
  DB_PASSWORD: "s3cr3t"  # k8s сам закодирует в base64
Подключение к поду
spec:
  containers:
    - name: app
      image: myapp:1.0
      envFrom:                       # все ключи ConfigMap как переменные окружения
        - configMapRef:
            name: app-config
      env:                           # точечно — из Secret
        - name: DB_PASSWORD
          valueFrom:
            secretKeyRef:
              name: app-secret
              key: DB_PASSWORD
      volumeMounts:                  # ConfigMap можно смонтировать как файлы
        - name: config
          mountPath: /etc/app
  volumes:
    - name: config
      configMap:
name: app-configNamespaces — логическое разделение кластера
Пространство имён (namespace) делит один кластер на изолированные логические области. Это основа мультитенантности: разные команды, проекты и окружения (dev/stage/prod) живут в одном кластере, не мешая друг другу. К namespace привязываются лимиты ресурсов (ResourceQuota) и права доступа (RBAC).
| Системный namespace | Назначение |
|---|---|
default |
Сюда попадают объекты, если namespace не указан явно. |
kube-system |
Компоненты самого кластера: CoreDNS, kube-proxy и прочие. |
kube-public |
Общедоступные данные кластера (используется редко). |
kube-node-lease |
Служебные объекты Lease для контроля доступности узлов. |
Работа с namespace
apiVersion: v1
kind: Namespace
metadata:
  name: team-payments
---
apiVersion: v1
kind: ResourceQuota          # потолок ресурсов на весь namespace
metadata:
  name: payments-quota
  namespace: team-payments
spec:
  hard:
    requests.cpu: "8"
    requests.memory: 16Gi
    limits.cpu: "16"
    limits.memory: 32Gi
    pods: "50"
# создать namespace и переключить контекст kubectl на него
kubectl create namespace team-payments
kubectl config set-context --current --namespace=team-payments
# посмотреть объекты конкретного namespace
kubectl get pods -n team-payments
# объекты всех namespace сразу
kubectl get pods --all-namespacesимя.namespace.svc.cluster.local, поэтому сервисы с одинаковым именем в dev и prod не конфликтуют.
Шпаргалка по kubectl
kubectl — единый инструмент командной строки для всего. Соберите эту таблицу в закладки — она закрывает 90% ежедневных задач:
| Команда | Что делает |
|---|---|
kubectl apply -f file.yaml |
Создать или обновить объекты из манифеста (декларативный подход) |
kubectl get pods / svc / deploy |
Список объектов; флаг -o wide — подробнее, -o yaml — полный объект |
kubectl describe pod имя |
Детали объекта и журнал событий — первый шаг любой диагностики |
kubectl logs имя [-c контейнер] |
Логи контейнера; -f — следить в реальном времени |
kubectl exec -it имя -- /bin/sh |
Интерактивная сессия внутри контейнера |
kubectl delete -f file.yaml |
Удалить объекты, описанные в манифесте |
kubectl port-forward svc/web 8080:80 |
Проброс порта сервиса на локальную машину для отладки |
kubectl top nodes / pods |
Потребление CPU и памяти (требуется metrics-server) |
kubectl api-resources |
Список всех типов объектов, доступных в кластере |
kubectl explain deployment.spec |
Встроенная документация по любому полю любого объекта |
Пробы: liveness, readiness, startup
Пробы (probes) — это проверки здоровья, которые kubelet выполняет для каждого контейнера. По их результатам Kubernetes решает, жив ли процесс и готов ли он принимать трафик. Пробы — обязательный элемент зрелого манифеста: без них кластер узнает о проблеме только от пользователей.
| Проба | Вопрос | Реакция при провале |
|---|---|---|
livenessProbe |
Жив ли процесс вообще? | Kubelet перезапускает контейнер (restartPolicy в действии) |
readinessProbe |
Готов ли под принимать трафик? | Под исключается из endpoints Service — трафик на него не идёт, но контейнер не перезапускается |
startupProbe |
Завершился ли долгий старт приложения? | Пока startup не пройден, liveness и readiness не проверяются; при провале — перезапуск |
Типичная конфигурация для HTTP-приложения выглядит так:
spec:
  containers:
    - name: app
      image: myapp:1.4
      startupProbe:          # защищает медленный старт (прогрев кеша, миграции)
        httpGet:
          path: /healthz
          port: 8080
        periodSeconds: 5
        failureThreshold: 24  # 24 × 5 с = до 2 минут на старт
      readinessProbe:        # готовность к трафику
        httpGet:
          path: /ready
          port: 8080
        periodSeconds: 10
      livenessProbe:         # защита от зависаний
        httpGet:
          path: /healthz
          port: 8080
        periodSeconds: 20
Помимо httpGet проба может быть tcpSocket (порт принимает соединения) или exec (команда внутри контейнера завершилась нулём). HTTP — самый информативный вариант: приложение само решает, считать ли себя здоровым, проверив зависимости.
initialDelaySeconds у liveness — и в мирное время проверка реагирует медленно. startupProbe снимает дилемму: щедрое время на старт и быстрые проверки после него.
Обновление и откат
Deployment умеет обновлять приложение без простоя: стратегия RollingUpdate поднимает новые поды и гасит старые постепенно, соблюдая ограничения maxSurge и maxUnavailable. Весь цикл управляется семейством команд kubectl rollout.
# обновить образ — запускается rolling update
kubectl set image deployment/web nginx=nginx:1.28

# наблюдать за обновлением в реальном времени
kubectl rollout status deployment/web

# история ревизий деплоймента
kubectl rollout history deployment/web

# детали конкретной ревизии
kubectl rollout history deployment/web --revision=3

# откат на предыдущую ревизию
kubectl rollout undo deployment/web

# откат на конкретную ревизию из истории
kubectl rollout undo deployment/web --to-revision=2
Механика проста: каждое изменение шаблона пода создаёт новую ревизию ReplicaSet, а старые ReplicaSet сохраняются — поэтому откат сводится к масштабированию прежнего набора реплик и занимает секунды. Если обновление пошло плохо, его можно поставить на паузу, разобраться и продолжить:
# приостановить обновление (новые поды перестанут появляться)
kubectl rollout pause deployment/web

# продолжить после проверки
kubectl rollout resume deployment/web

# если совсем плохо — откат
kubectl rollout undo deployment/webreadinessProbe: неготовые поды не считаются успешно обновлёнными. Именно поэтому пробы и rollout — пара: пробы из предыдущего раздела превращают обновление из «замены вслепую» в контролируемый процесс, который сам останавливается при проблемах.
Собираем всё вместе
Типичная минимальная «стопка» для одного приложения выглядит так:
- Namespace — логическое место приложения в кластере;
- ConfigMap и Secret — конфигурация и чувствительные данные;
- Deployment — три реплики приложения с пробами и лимитами;
- Service — стабильная точка доступа к репликам.
Все четыре манифеста можно хранить в одном файле, разделяя их строкой ---, и применять одной командой kubectl apply. Дальше остаётся опубликовать приложение наружу через Ingress и настроить автомасштабирование — об этом в разделе «Продвинутый уровень».